คุณฝึกงานกับกลุ่มวิจัยชีวสารสนเทศที่ศึกษา DNA สาย DNA หนึ่งสายประกอบด้วยยีนจำนวนมาก ซึ่งแบ่งเป็นหมวดหมู่ต่าง ๆ ที่เรียกว่าชนิดยีน ชนิดยีนถูกคั่นด้วยลำดับนิวคลีโอไทด์เฉพาะที่เรียกว่าเครื่องหมายยีน ยีนแต่ละชนิด $i$ มีเครื่องหมายเริ่มต้น $s_i$ และเครื่องหมายสิ้นสุด $e_i$ ที่เป็นเอกลักษณ์ของตน หลังจากทำงานยุ่งยากมากมาย (เพาะเลี้ยงแบคทีเรีย สกัดเซลล์ วิศวกรรมโปรตีน และอื่น ๆ) กลุ่มวิจัยของคุณสามารถแปลง DNA ให้เหลือเพียงเครื่องหมายยีน โดยนำสารพันธุกรรมทั้งหมดที่อยู่ระหว่างเครื่องหมายออก
กลุ่มวิจัยตั้งสมมติฐานที่น่าสนใจว่าการตีความยีนขึ้นอยู่กับว่าเครื่องหมายของยีนบางชนิดสร้างโครงสร้างที่ซ้อนกันอย่างถูกต้องหรือไม่ ในการตัดสินว่าเครื่องหมายของยีนชนิด $i$ ซ้อนกันอย่างถูกต้องในลำดับเครื่องหมาย $w$ ที่กำหนดหรือไม่ ต้องพิจารณาลำดับย่อยของ $w$ ที่มีเฉพาะเครื่องหมายของยีนชนิด $i$ ($s_i$ และ $e_i$) โดยไม่ละเครื่องหมายเหล่านั้นแม้แต่ตัวเดียว โครงสร้างต่อไปนี้และเฉพาะโครงสร้างเหล่านี้เท่านั้นที่ถือว่าซ้อนกันอย่างถูกต้อง:
- $s_i e_i$
- $s_i N e_i$ โดยที่ $N$ เป็นโครงสร้างที่ซ้อนกันอย่างถูกต้อง
- $AB$ โดยที่ $A$ และ $B$ เป็นโครงสร้างที่ซ้อนกันอย่างถูกต้อง
ด้วยพื้นฐานด้านคอมพิวเตอร์ของคุณ คุณได้รับมอบหมายให้ศึกษาสมบัตินี้ แต่ยังมีความยุ่งยากอีกอย่างหนึ่ง กลุ่มของคุณกำลังศึกษา DNA ชนิดพิเศษที่เรียกว่า DNA วงแหวน ซึ่งเป็น DNA ที่สร้างวงปิด หากต้องการศึกษาการซ้อนกันใน DNA วงแหวน ต้องตัดวงที่ตำแหน่งหนึ่งเพื่อให้ได้ลำดับเครื่องหมายที่แน่นอนเพียงลำดับเดียว (ทิศทางการอ่านถูกกำหนดไว้ด้วยสมบัติของโมเลกุล) การที่ยีนชนิด $i$ ซ้อนกันอย่างถูกต้องหรือไม่จึงขึ้นอยู่กับตำแหน่งที่ตัด DNA วงแหวนด้วย งานของคุณคือหาตำแหน่งตัดที่ทำให้จำนวนชนิดยีนที่สร้างโครงสร้างซ้อนกันอย่างถูกต้องมีค่ามากที่สุด รูป D.1 แสดงตัวอย่างที่ตรงกับข้อมูลนำเข้าตัวอย่าง 1 การตัดตามตำแหน่งที่ระบุทำให้เครื่องหมายของยีนชนิด 1 ซ้อนกันอย่างถูกต้อง
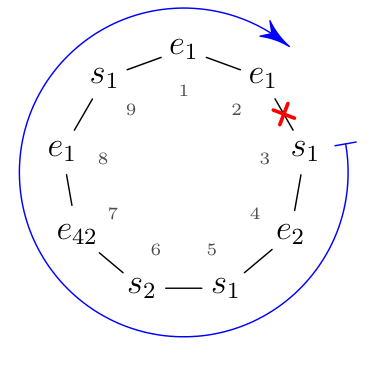
รูป D.1: ภาพประกอบข้อมูลนำเข้าตัวอย่าง 1 พร้อมตำแหน่งตัดที่เหมาะที่สุด
ข้อมูลนำเข้า
บรรทัดแรกของข้อมูลนำเข้ามีจำนวนเต็ม $n$ ($1 \le n \le 10^6$) ซึ่งเป็นความยาวของ DNA บรรทัดถัดไปมีลำดับ DNA นั่นคือเครื่องหมาย $n$ ตัว เครื่องหมายแต่ละตัวประกอบด้วยอักขระ $c$ ตามด้วยจำนวนเต็ม $i$ โดย $c \in \{s,e\}$ ระบุว่าเป็นเครื่องหมายเริ่มต้นหรือสิ้นสุด และ $i$ ($1 \le i \le 10^6$) คือชนิดยีนของเครื่องหมายนั้น ลำดับ DNA ที่กำหนดได้จากการตัด DNA วงแหวนที่ตำแหน่งใดตำแหน่งหนึ่งตามอำเภอใจ
ข้อมูลส่งออก
ส่งออกหนึ่งบรรทัดที่มีจำนวนเต็มสองจำนวน $p$ และ $m$ โดย $p$ คือตำแหน่งตัดที่ทำให้จำนวนชนิดยีนที่แตกต่างกันซึ่งซ้อนกันอย่างถูกต้องมีค่ามากที่สุด และ $m$ คือจำนวนชนิดยีนสูงสุดนั้น DNA จะถูกตัดตรงก่อนเครื่องหมายตัวที่ $p$ ในข้อมูลนำเข้า (เช่น การตัดในรูป D.1 มี $p = 3$) หากมีหลายตำแหน่งตัดที่ให้ค่าสูงสุดของ $m$ เท่ากัน ให้ส่งออก $p$ ที่น้อยที่สุดในบรรดาตำแหน่งเหล่านั้น
ตัวอย่าง
ข้อมูลนำเข้า 1
9
e1 e1 s1 e2 s1 s2 e42 e1 s1
ข้อมูลส่งออก 1
3 1
ข้อมูลนำเข้า 2
8
s1 s1 e3 e1 s3 e1 e3 s3
ข้อมูลส่งออก 2
8 2